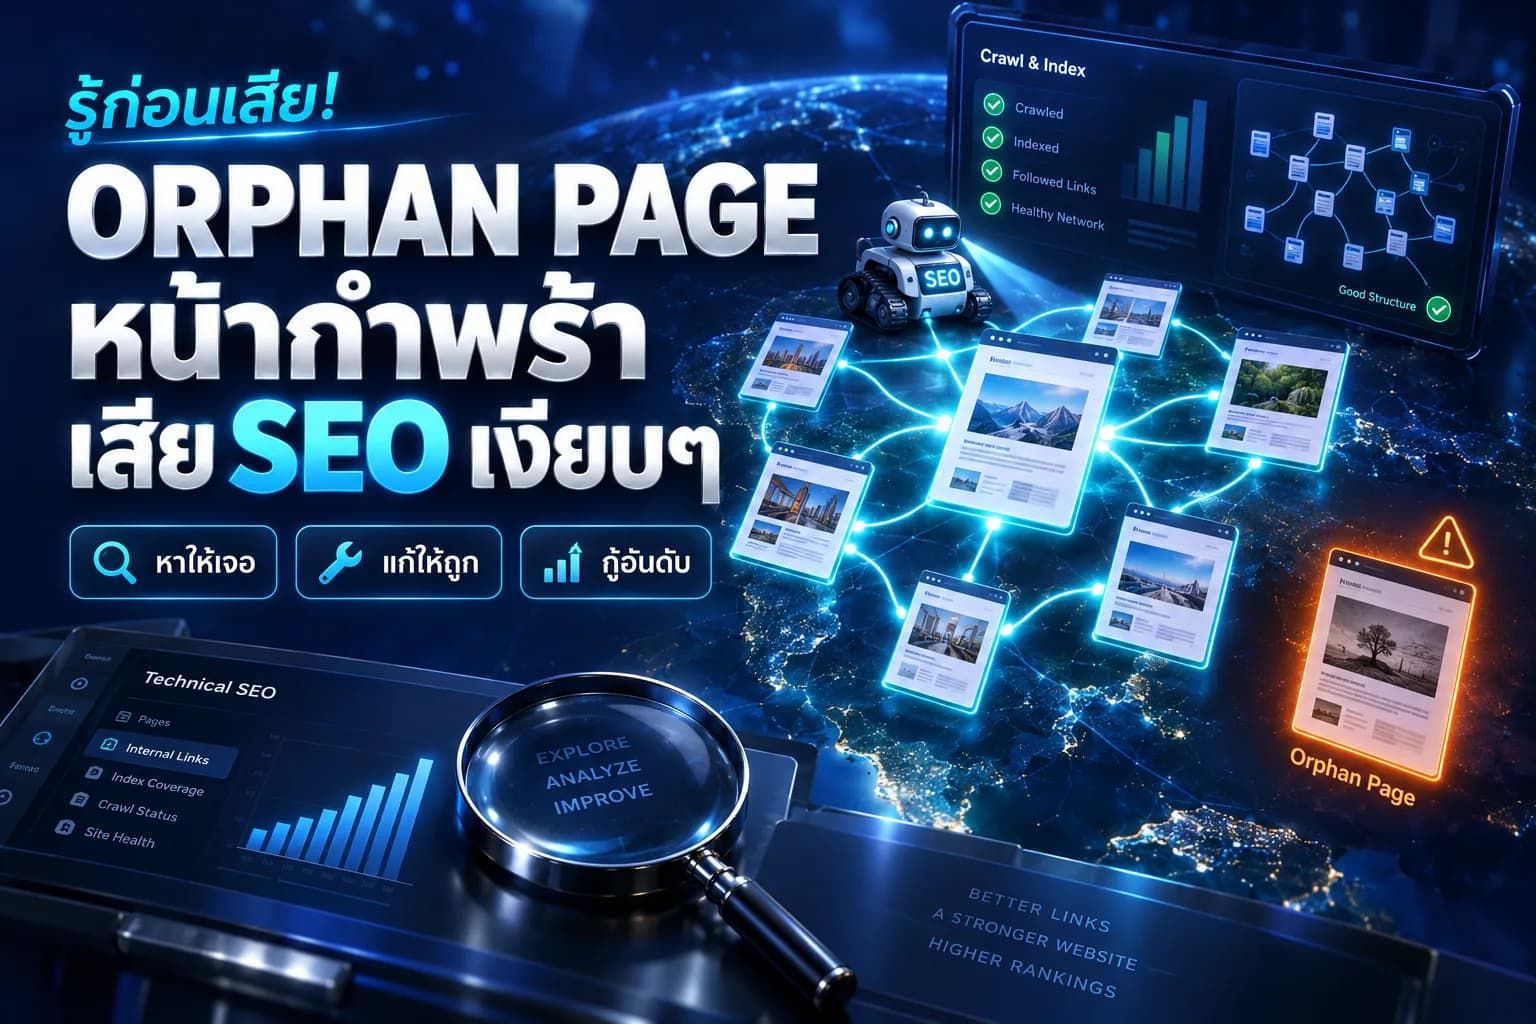
หลายเว็บมีหน้าที่เขียนดี ข้อมูลครบ เปิดเข้าไปก็แสดงผลปกติทุกอย่าง แต่กลับไม่เคยมี traffic จาก Google เข้ามาเลยสักครั้ง พอไล่ดูทีละจุดก็ไม่เจออะไรผิดชัด ๆ ไม่ได้ติด noindex ไม่ได้โดนบล็อกใน robots.txt เนื้อหาก็ไม่ได้บาง ปัญหาที่ซ่อนอยู่หลายครั้งไม่ได้อยู่ในตัวหน้านั้น แต่อยู่ที่ "ไม่มีเส้นทางไหนในเว็บเดินไปถึงหน้านั้นได้เลย" ซึ่งเรียกกันว่า Orphan Page หรือหน้ากำพร้า
เรื่องนี้สำคัญเพราะ Google ไม่ได้เดินดูเว็บแบบเปิดโฟลเดอร์ไฟล์ แต่เดินตามลิงก์จากหน้าหนึ่งไปอีกหน้าหนึ่งเป็นหลัก หน้าที่ไม่มีใครในเว็บชี้ถึงจึงอยู่นอกแผนที่ไปโดยปริยาย ถูกเจอช้า ถูกกลับมาเก็บซ้ำน้อย และแทบไม่ได้รับแรงส่งจากหน้าอื่นในเว็บเลย ยิ่งเว็บโตขึ้น มีการรีดีไซน์ ย้ายระบบ หรือทำ landing page แคมเปญบ่อย ๆ หน้ากำพร้ายิ่งสะสมโดยไม่มีใครรู้ตัว บทความนี้จะไล่ตั้งแต่นิยามที่แม่นยำ สาเหตุที่พบจริง ผลกระทบต่อ SEO วิธีตรวจหา ไปจนถึงลำดับการแก้ที่ไม่ใช่แค่ยัดลิงก์มั่ว
Orphan Page คืออะไร ต่างจากหน้าที่ไม่ถูก Index ตรงไหน
Orphan Page คือหน้าเว็บที่มีอยู่จริงบนเซิร์ฟเวอร์ เปิด URL เข้าไปก็แสดงผลได้ปกติ แต่ไม่มี internal link จากหน้าไหนในเว็บเดียวกันชี้มาถึงเลยแม้แต่จุดเดียว บางหน้าอาจถูก Google index ไปแล้วด้วยซ้ำ (เพราะอยู่ใน sitemap หรือมีเว็บนอกลิงก์มา) แต่ในแง่โครงสร้างเว็บมันคือหน้าที่ลอยอยู่นอกแผนผัง ไม่ได้เชื่อมกับเมนู หมวดหมู่ breadcrumb หรือบทความไหนทั้งสิ้น
จุดที่คนสับสนบ่อยที่สุดคือเอาไปปนกับ "หน้าที่ไม่ถูก index" ซึ่งเป็นคนละเรื่องกัน หน้าที่ไม่ถูก index อาจมีลิงก์ภายในชี้เข้าเพียบ เมนูก็มี บทความก็ลิงก์ถึง แต่ติด noindex ตั้ง canonical ชี้ไปหน้าอื่น หรือโดนกันไว้ใน robots.txt ปัญหาจึงอยู่ที่คำสั่งบอกเครื่องมือค้นหา ไม่ใช่ที่เส้นทางเดิน ส่วนหน้ากำพร้าคือปัญหาเส้นทางล้วน ๆ คำสั่งทุกอย่างอาจถูกต้องหมดแต่ไม่มีใครพาไปถึง
อีกคำที่มักถูกใช้สลับกันคือ broken link หรือหน้า 404 ซึ่งตรงข้ามกับหน้ากำพร้าโดยสิ้นเชิง broken link คือมีลิงก์ชี้ไปหาหน้าที่ ไม่มีอยู่แล้ว ส่วนหน้ากำพร้าคือหน้ามีอยู่ครบสมบูรณ์แต่ไม่มีลิงก์ชี้มา การแยกสามอย่างนี้ให้ออกตั้งแต่ต้นสำคัญมาก เพราะวิธีแก้คนละทางกันหมด และการวินิจฉัยผิดตั้งแต่แรกทำให้เสียเวลาไปกับการแก้สิ่งที่ไม่ใช่ต้นเหตุ
หน้ากำพร้าเกิดขึ้นได้ยังไง สาเหตุที่เจอจริงบ่อยที่สุด
หน้ากำพร้าเกือบทั้งหมดไม่ได้เกิดจากความตั้งใจ แต่เกิดจากการเปลี่ยนแปลงโครงสร้างเว็บที่ทำไปครึ่งทาง หรือระบบที่สร้างหน้าใหม่ได้เองแต่ไม่ได้สร้างลิงก์ให้เอง ยิ่งเว็บมีหลายคนดูแลและมีการทำแคมเปญแยกจากงานคอนเทนต์หลัก โอกาสเกิดยิ่งสูง
ด้านล่างคือรูปแบบที่เจอซ้ำ ๆ ในการทำ audit เว็บไทย ลองไล่เทียบดูว่าเว็บของคุณเคยผ่านเหตุการณ์ไหนมาบ้าง เพราะจุดที่เคยแก้โครงสร้างมักเป็นจุดเดียวกับที่ทิ้งหน้ากำพร้าไว้
รื้อเมนูหรือลบหมวดหมู่ แต่ลืมว่าหน้ายังอยู่
เคสคลาสสิกที่สุดคือเอาเมนูเก่าออก ปิดหมวดหมู่ที่เลิกทำ หรือลบหน้ารวมลิงก์ทิ้ง โดยคิดว่าหน้าที่อยู่ข้างใต้มันหายไปด้วย ความจริงคือ URL เดิมยังเปิดได้อยู่ทุกหน้า เพียงแต่ไม่มีประตูให้เดินเข้าอีกแล้ว หน้าเหล่านี้มักเป็นหน้าที่เคยมีอันดับด้วยซ้ำ พอถูกตัดออกจากโครงสร้างก็ค่อย ๆ อ่อนแรงลงเงียบ ๆ
Landing page แคมเปญโฆษณาที่ตั้งใจแยกเดี่ยว
หน้าสำหรับยิงโฆษณามักถูกทำแยกจากเว็บหลัก ไม่ใส่ในเมนู ไม่มีบทความไหนลิงก์ถึง เพราะอยากให้คนเข้ามาแล้วเห็นแต่ข้อเสนอเดียว ในมุมโฆษณาไม่ผิด แต่ถ้าหน้านั้นเปิดให้ index ด้วย มันก็คือหน้ากำพร้าที่จะไม่มีวันแข่งในผลค้นหาแบบธรรมชาติได้เลย ต้องตัดสินใจให้ชัดว่าจะให้หน้านี้ทำหน้าที่อะไรกันแน่
Pagination และ infinite scroll ตัดหน้าลึกออกจากเส้นทาง
บล็อกที่มีบทความหลายร้อยชิ้นมักมีหน้า 2, 5, 10, 20 ต่อกันไป ถ้าเปลี่ยนไปใช้ infinite scroll ที่โหลดด้วย JavaScript ล้วน หรือทำ pagination ที่โชว์แค่ปุ่มถัดไปทีละหน้า บทความเก่าที่อยู่ลึกอาจตกอยู่ไกลเกินกว่าที่บอทจะเดินถึงในทางปฏิบัติ กลายเป็นกึ่งกำพร้าทั้งชุดโดยไม่มีใครสังเกต
CMS เผยแพร่อัตโนมัติ แต่ไม่ได้สร้างลิงก์ให้อัตโนมัติ
ระบบหลังบ้านหลายตัวสร้างหน้าใหม่ได้เองจากการตั้งเวลา นำเข้าไฟล์ หรือสร้างหน้าสินค้าจากสต็อก แต่ไม่ได้ผูกหน้านั้นเข้ากับ related posts หมวดหมู่ หรือหน้ารวมใด ๆ ถ้าคนเขียนไม่ไปเติมลิงก์เอง หน้าใหม่ก็เกิดมาโดดเดี่ยวตั้งแต่วันแรก
ย้ายเว็บ รีดีไซน์ หรือเปลี่ยน CMS แล้วโยกไม่ครบ
ตอนย้ายระบบ คนมักโฟกัสที่หน้าสำคัญและหน้าที่มี traffic สูงก่อน หน้าที่เหลือถูกยกมาแต่ตัวเนื้อหา ส่วนลิงก์ที่เคยชี้หากันในธีมเก่าหายไปพร้อมโครงเดิม ผลคือหลังย้ายเว็บเสร็จสวยงาม กลับมีหน้ากำพร้าเพิ่มขึ้นเป็นกอง ควรตรวจเรื่องนี้เป็นงานประจำหลังย้ายเสมอ ควบคู่กับการวาง โครงสร้างเว็บให้เอื้อต่อ SEO ใหม่ทั้งชุด
ไฟล์ PDF และหน้าที่ตั้งใจซ่อน แต่ยังอยู่ใน sitemap
ใบเสนอราคา โบรชัวร์ PDF หน้าขอบคุณหลังกรอกฟอร์ม หรือหน้าทดสอบที่เคยทำไว้ มักถูกถอดออกจากเมนูแต่ยังถูกใส่อยู่ใน sitemap.xml อัตโนมัติ กลายเป็นหน้ากำพร้าที่ Google รู้จักแต่ไม่มีบริบทอะไรรองรับเลย บางกรณีวิธีแก้ที่ถูกไม่ใช่การเติมลิงก์ แต่คือการตัดออกจาก sitemap แล้วปิด index ให้ชัดเจน
Orphan Page ส่งผลเสียกับ SEO ยังไงบ้าง
ผลเสียหลักคือหน้านั้นถูกค้นพบยากและอ่อนแรงกว่าที่ควรจะเป็น เพราะGoogle ใช้เส้นทางลิงก์ภายในเป็นทางหลักในการเดินสำรวจเว็บ เมื่อไม่มีลิงก์ชี้มาเลย หน้านั้นเหลือทางเข้าทางเดียวคือ sitemap ซึ่งเป็นแค่การแจ้งรายชื่อ ไม่ใช่สัญญาณบอกความสำคัญ
ผลกระทบที่ตามมาแยกได้เป็นสี่ด้าน
อีกมุมที่คนมองข้ามคือความเสียหายสะสม ถ้าเว็บมีหน้ากำพร้าหลักสิบหลักร้อยหน้าค้างอยู่ใน sitemap บอทจะเสียเวลาไปกับการไล่เก็บหน้าที่ไม่มีบริบทรองรับ แทนที่จะกลับมาเก็บหน้าสำคัญให้ถี่ขึ้น เรื่องนี้เชื่อมตรงกับการบริหาร crawl budget หรืองบคลานของเว็บ โดยเฉพาะเว็บที่มี URL หลักพันขึ้นไป
- ถูกค้นพบช้าหรือไม่ถูกค้นพบเลย เพราะไม่มีเส้นทางเดินไปถึงจากหน้าอื่น เหลือแค่ sitemap เป็นช่องทางเดียว
- ไม่ได้รับการส่งต่อน้ำหนักจากหน้าอื่นในเว็บ อันดับจึงอ่อนกว่าหน้าที่เนื้อหาพอกันแต่มีลิงก์ภายในรองรับ
- ถูกกลับมาเก็บซ้ำน้อย เนื้อหาที่อัปเดตแล้วอาจใช้เวลานานกว่าจะสะท้อนในผลค้นหา
- วิเคราะห์ผลยาก เพราะการไล่ดูโครงสร้างลิงก์และการจัดกลุ่มหน้าตามหมวดจะไม่เห็นหน้านี้ ทำให้มันหลุดจากรายงานภายในของทีมไปด้วย
จะหาหน้ากำพร้าในเว็บตัวเองได้ยังไง
หลักการเดียวกันทุกวิธีคือ เอา "รายชื่อ URL ที่เรารู้ว่ามีอยู่" มาเทียบกับ "รายชื่อ URL ที่เดินตามลิงก์จริงในเว็บแล้วเจอ" ตัวที่อยู่ในกองแรกแต่ไม่โผล่ในกองที่สอง คือผู้ต้องสงสัยว่าเป็นหน้ากำพร้า
วิธีที่ตรงที่สุดคือรัน crawler อย่าง Screaming Frog แบบเดินตามลิงก์จริงในเว็บ (ไม่ใช่โหมดอ่าน sitemap) รุ่นฟรีก็ไล่ได้ในระดับเว็บขนาดเล็กถึงกลาง แล้วเอาผลลัพธ์ไปเทียบกับ URL ทั้งหมดใน sitemap.xml จากนั้นเสริมด้วยข้อมูลฝั่งผู้ใช้จาก Analytics และข้อมูลฝั่งบอทจาก Search Console หรือ log file analysis ถ้าเข้าถึง log เซิร์ฟเวอร์ได้ ยิ่งใช้หลายแหล่งมาเทียบกัน ภาพยิ่งครบ เพราะแต่ละแหล่งมองเห็นคนละมุม
ตารางด้านล่างเทียบให้เห็นว่าแต่ละวิธีเหมาะกับอะไร และมีจุดบอดตรงไหน สำหรับเว็บทั่วไปที่มีไม่กี่ร้อย URL เริ่มจากสองแถวแรกก็เพียงพอแล้ว ส่วนเว็บใหญ่ควรทำครบทั้งสี่ทางเป็นรอบ ๆ
| วิธีตรวจ | ข้อมูลที่เอามาเทียบ | จุดแข็ง | ข้อจำกัด |
|---|---|---|---|
| Crawler เดินลิงก์จริง เทียบ sitemap.xml | URL ที่ crawler เดินถึง เทียบกับ URL ทั้งหมดใน sitemap | เห็นโครงสร้างลิงก์ทั้งเว็บ ชี้ตัวต้องสงสัยได้ตรงที่สุด | หน้าที่ไม่อยู่ทั้งใน crawl และ sitemap จะไม่โผล่ ต้องหารายชื่อ URL จากแหล่งอื่นมาเสริม |
| Google Search Console | หน้าที่ Google รู้จักและมี impression เทียบกับผล crawl | ใช้ฟรี เห็นหน้าที่ Google เจอจริงและเคยแสดงผลจริง | รายงานลิงก์เป็นเพียงตัวอย่าง ไม่ใช่รายการครบ และไม่มีป้ายบอกว่าหน้าไหนกำพร้า |
| Google Analytics (GA4) | URL ที่มีการเข้าชม เทียบกับผล crawl | จับหน้าที่มีคนเข้าจริงแต่ไม่มีเส้นทางในเว็บได้ดี | เห็นเฉพาะหน้าที่ติดแท็กและมีคนเข้า หน้าที่เงียบสนิทจะไม่ปรากฏ |
| Log file analysis | URL ที่ Googlebot เข้าจริงจาก log เซิร์ฟเวอร์ เทียบ sitemap และ crawl | เห็นพฤติกรรมบอทจริง ไม่ใช่การอนุมาน | ต้องมีสิทธิ์เข้าถึง log และเครื่องมือประมวลผล ทำยากที่สุดในสี่วิธี |
แก้หน้ากำพร้ายังไงให้ถูกวิธี ไม่ใช่แค่ยัดลิงก์
วิธีแก้ที่ถูกคือพาหน้านั้นกลับเข้าโครงสร้างเว็บอย่างมีเหตุผล ไม่ใช่เอาลิงก์ไปแปะที่ไหนก็ได้ให้ครบจำนวน ลิงก์ที่ได้ผลต้องมาจากหน้าที่เนื้อหาเกี่ยวข้องกันจริง เพราะลิงก์ในบริบทที่เกี่ยวข้องช่วยทั้งการค้นพบ การส่งน้ำหนัก และการบอกเครื่องมือค้นหาว่าหน้านั้นพูดเรื่องอะไร
ลำดับการแก้ที่ใช้ได้กับเว็บส่วนใหญ่
ทำเสร็จแล้วอย่าลืมรัน crawl ซ้ำอีกรอบเพื่อยืนยันว่าเดินจากหน้าแรกไปถึงหน้านั้นได้จริง หลายครั้งลิงก์ที่เติมเข้าไปอยู่ในส่วนที่โหลดด้วย JavaScript หรืออยู่ในบล็อกที่ซ่อนบนมือถือ ซึ่งอาจไม่ถูกนับเป็นเส้นทางเดินที่มั่นคง หลักการวางลิงก์ให้เป็นระบบอ่านต่อได้ในบทความเรื่อง การทำ internal link ให้ช่วย SEO จริง
- เติม contextual link จากบทความหรือหน้าบริการที่พูดเรื่องใกล้กัน วาง anchor ให้อ่านแล้วรู้ว่าปลายทางคืออะไร
- ผูกเข้ากับโครงหลักตามชนิดของหน้า เช่น ใส่กลับเมนู ใส่หมวดหมู่ เปิด breadcrumb หรือให้โผล่ในบล็อกบทความที่เกี่ยวข้อง
- จัดกลุ่มเป็น content hub โดยทำหน้าเสาหลักที่ลิงก์ไปบทความย่อยทุกชิ้นในคลัสเตอร์นั้นอย่างเป็นระบบ แทนการไล่แปะลิงก์ทีละจุดแบบไม่มีแผน
- คงหน้านั้นไว้ใน sitemap.xml ควบคู่ไปด้วย เพื่อให้ Google รู้ว่ามีหน้านี้อยู่ ไม่ใช่เลือกอย่างใดอย่างหนึ่ง
- หน้าไหนที่ไม่ควรอยู่ในผลค้นหาอยู่แล้ว เช่น หน้าขอบคุณหลังกรอกฟอร์ม ให้ปิด index และถอดออกจาก sitemap แทนการฝืนหาลิงก์มาใส่
ใส่หน้าไว้ใน sitemap.xml แล้วยังต้องมี internal link อีกไหม
ยังต้องมี เพราะsitemap เป็นแค่บัญชีรายชื่อ ไม่ใช่สัญญาณบอกความสำคัญ Google อาจใช้เวลานานกว่าจะไล่เก็บ URL จาก sitemap และให้น้ำหนักกับหน้าที่ไม่มีลิงก์ภายในรองรับน้อยกว่าอยู่ดี การใส่ sitemap จึงแก้ได้แค่เรื่อง "รู้ว่ามีหน้านี้อยู่" ไม่ได้แก้เรื่อง "หน้านี้สำคัญแค่ไหนในเว็บ"
ให้คิดว่า sitemap คือรายชื่อห้องทั้งหมดในตึก ส่วน internal link คือทางเดินจริงที่พาคนไปถึงห้องนั้น ถ้ามีแต่รายชื่อแต่ไม่มีทางเดิน คนที่เดินสำรวจตึกก็มีโอกาสข้ามห้องนั้นไป และถ้าห้องไหนมีทางเดินจากโถงหลักหลายทาง ก็ย่อมถูกตีความว่าเป็นห้องสำคัญกว่าโดยธรรมชาติ
อีกจุดที่ควรเช็กควบคู่กันคือ sitemap กับ robots.txt ต้องไม่ขัดกันเอง เช่น ใส่ URL ไว้ใน sitemap แต่ดันบล็อกพาธนั้นไว้ในไฟล์ robots ซึ่งเป็นคนละปัญหากับหน้ากำพร้าแต่มักเจอพร้อมกันเวลาเว็บผ่านการรื้อโครงสร้าง รายละเอียดของสองไฟล์นี้อ่านต่อได้ที่ sitemap.xml กับ robots.txt ต่างกันยังไง
หน้ากำพร้าแปลว่าไม่มีคนเข้าเลยใช่ไหม
ไม่ใช่ หน้ากำพร้ายังรับคนเข้าได้ตามปกติ ทั้งจากลิงก์ของเว็บอื่น โซเชียล อีเมล โฆษณา หรือคนพิมพ์ URL ตรง ๆ สิ่งที่มันขาดคือเส้นทางภายในเว็บ ไม่ใช่ผู้เข้าชม หลายเว็บจึงมีหน้าที่มียอดเข้าดีพอตัวแต่ยังเป็นหน้ากำพร้าอยู่เต็ม ๆ
ความเข้าใจผิดนี้อันตรายตรงที่ทำให้คนตัดสินจากตัวเลข traffic อย่างเดียวว่า "หน้านี้ไม่กำพร้า เพราะมีคนเข้า" แล้วปล่อยผ่านไป ทั้งที่การมีคนเข้าจากช่องทางอื่นไม่ได้แปลว่าบอทเดินไปถึงหน้านั้นได้ผ่านลิงก์ภายในเลย หน้าที่มีโฆษณาวิ่งอยู่หรือมีคนแชร์บ่อยยิ่งเข้าข่ายนี้ง่าย
ในทางกลับกัน หน้าที่ไม่มีคนเข้าเลยก็ไม่ได้แปลว่าเป็นหน้ากำพร้าเสมอไป อาจมีลิงก์ภายในครบแต่เนื้อหาไม่ตรงกับสิ่งที่คนค้นหา หรือแข่งไม่ไหวในคำนั้น การสรุปจากตัวเลขเข้าชมอย่างเดียวจึงวินิจฉัยผิดได้ทั้งสองทาง ต้องดูที่โครงสร้างลิงก์จริงเท่านั้น และใช้ข้อมูลจาก Google Search Console มาประกอบว่าหน้านั้นถูกเจอและแสดงผลอยู่ในสถานะไหน
ต้องแก้ทุกหน้าไหม ควรจัดลำดับความสำคัญยังไง
ไม่จำเป็นต้องแก้ทุกหน้า เพราะหน้ากำพร้าบางประเภทตั้งใจให้เป็นแบบนั้นอยู่แล้ว สิ่งที่ต้องทำคือแยกให้ออกว่าหน้าไหน "ควรอยู่ในผลค้นหา" และหน้าไหน "ไม่ควรอยู่ตั้งแต่แรก" แล้วจัดการคนละแบบ
ลำดับที่แนะนำคือเริ่มจากหน้าที่มีศักยภาพทางธุรกิจก่อน ได้แก่ หน้าบริการ หน้าสินค้า และบทความที่มี impression ใน Search Console อยู่แล้วแต่อันดับยังไม่ดี กลุ่มนี้แค่ได้ลิงก์ภายในที่เหมาะสมก็มีโอกาสขยับ ถัดมาคือบทความเก่าที่ยังมีคุณค่าแต่หลุดจากโครงสร้างหลังรีดีไซน์ ส่วนกลุ่มสุดท้ายคือหน้าที่ไม่ควรถูก index เช่น หน้าทดสอบ หน้าขอบคุณ หรือไฟล์แนบภายใน ให้ปิด index และถอดจาก sitemap ไปเลย
ข้อควรระวังสำคัญคือ อย่าเพิ่งลบหน้าทิ้งก่อนตรวจว่ามี traffic หรือมีเว็บนอกลิงก์เข้าอยู่หรือเปล่า เพราะการลบหน้าที่ยังมีคนใช้งานหรือมี backlink จะเปลี่ยนปัญหาเล็กให้กลายเป็นปัญหาใหญ่กว่าเดิม ถ้าตัดสินใจเอาออกจริงควรทำ redirect ไปหน้าที่ใกล้เคียงที่สุดแทนการปล่อย 404 ทิ้งไว้เฉย ๆ
ถ้าเว็บผ่านการรีดีไซน์หรือย้ายระบบมาแล้วไม่แน่ใจว่าเหลือหน้ากำพร้าค้างอยู่กี่หน้า การทำ SEO Audit ตรวจสุขภาพเว็บ สักรอบจะช่วยให้เห็นภาพโครงสร้างลิงก์ทั้งเว็บพร้อมกันทีเดียว และรู้ว่าควรเริ่มแก้จากหน้าไหนก่อนตามผลกระทบจริง
คำถามที่พบบ่อย
01Orphan Page กับหน้าที่ Google ไม่ index ต่างกันยังไง+
หน้ากำพร้าคือหน้าที่ไม่มี internal link จากหน้าอื่นในเว็บชี้มาเลย แม้ตัวหน้าอาจถูก index ไปแล้วก็ตาม ส่วนหน้าที่ไม่ถูก index คือหน้าที่อาจมีลิงก์เข้าครบแต่ติด noindex ตั้ง canonical ชี้ไปหน้าอื่น หรือถูกบล็อกไว้ สาเหตุคนละจุดและวิธีแก้คนละทางกัน
02เช็กหน้ากำพร้าโดยไม่ใช้เครื่องมือเสียเงินได้ไหม+
ได้ในระดับหนึ่ง วิธีพื้นฐานคือใช้ crawler รุ่นฟรีที่จำกัดจำนวน URL เดินลิงก์จริงในเว็บ แล้วเอารายชื่อที่ได้ไปเทียบกับ URL ทั้งหมดใน sitemap.xml ร่วมกับดูรายงานหน้าใน Google Search Console และ GA4 เว็บเล็กที่มีไม่กี่สิบหน้ามักตรวจด้วยวิธีนี้ได้ครบ ส่วนเว็บใหญ่หลักพัน URL ขึ้นไปจะทำได้ลำบากกว่ามาก
03หน้ากำพร้าทำให้ทั้งเว็บโดนลงโทษไหม+
การมีหน้ากำพร้าไม่ใช่การละเมิดกฎ จึงไม่ได้ทำให้เว็บถูกลงโทษโดยตรง ผลกระทบเป็นเรื่องประสิทธิภาพมากกว่า คือหน้านั้นถูกค้นพบยาก ถูกเก็บซ้ำน้อย และไม่ได้รับแรงส่งจากหน้าอื่น ถ้าสะสมจำนวนมากก็ทำให้การไล่เก็บหน้าทั้งเว็บมีประสิทธิภาพลดลงตามไปด้วย
04แก้หน้ากำพร้าแล้วอันดับจะขึ้นเมื่อไหร่+
ไม่มีกรอบเวลาตายตัวและไม่มีใครรับประกันผลได้ สิ่งที่บอกได้คือหลังเติมลิงก์ภายในแล้ว Google ต้องกลับมาเก็บหน้านั้นใหม่ก่อนจึงจะเห็นความเปลี่ยนแปลง ระหว่างนี้ควรติดตาม impression และสถานะการ index ใน Search Console ว่าขยับไปในทางที่ดีขึ้นหรือไม่ ส่วนอันดับสุดท้ายยังขึ้นกับคุณภาพเนื้อหาและการแข่งขันในคำนั้นด้วย
05Landing page โฆษณาควรทำให้เลิกเป็นหน้ากำพร้าไหม+
ขึ้นกับว่าต้องการให้หน้านั้นติดผลค้นหาแบบธรรมชาติด้วยหรือไม่ ถ้าต้องการ ก็ควรเชื่อมเข้ากับโครงสร้างเว็บและทำเนื้อหาให้สมบูรณ์พอจะแข่งได้ แต่ถ้าตั้งใจใช้กับโฆษณาอย่างเดียว การปิด index และถอดออกจาก sitemap จะตรงไปตรงมากว่า ไม่ควรปล่อยให้อยู่กึ่งกลางคือเปิดให้ index แต่ไม่มีลิงก์ใดชี้ถึง