เจ้าของเว็บหลายคนเคยเจอเหตุการณ์แบบนี้: อยู่ ๆ วันหนึ่งกราฟทราฟฟิกก็พุ่งขึ้นมาเป็นเท่าตัวโดยไม่มีสัญญาณล่วงหน้า พอเปิด Google Analytics ดูก็เห็นว่าผู้ใช้เข้ามาจากมือถือเกือบทั้งหมด แต่พอไปไล่หาว่ามาจากคีย์เวิร์ดไหนกลับหาไม่เจอสักคำ แล้วอีกสามวันต่อมาทราฟฟิกก้อนนั้นก็หายไปเงียบ ๆ เหมือนไม่เคยมี สิ่งที่เกิดขึ้นส่วนใหญ่คือบทความนั้นถูกหยิบไปแสดงใน Google Discover ซึ่งเป็นช่องทางที่ทำงานคนละแบบกับผลค้นหาที่เราคุ้นเคย
ความสับสนจึงเกิดขึ้นตามมาว่าต้องทำ SEO แบบไหนถึงจะติด Discover ต้องใส่ schema ตัวไหนเพิ่ม ต้องยิงคีย์เวิร์ดอะไร คำตอบสั้น ๆ คือไม่มีปุ่มลัดแบบนั้นเลย เพราะ Discover ไม่ได้ทำงานจากคำค้นตั้งแต่แรก บทความนี้จะอธิบายตั้งแต่กลไกพื้นฐาน ความต่างจาก Google Search ปัจจัยที่ Google บอกเองว่าให้ความสำคัญ ข้อกำหนดเรื่องภาพที่หลายเว็บพลาดแบบไม่รู้ตัว วิธีเช็คผลจริงใน Search Console ไปจนถึงสาเหตุที่ทำให้เว็บหลุดจากฟีด และควรวางน้ำหนักกับช่องทางนี้แค่ไหนถึงจะไม่เสียเวลาเปล่า
Google Discover คืออะไร และทำงานยังไง
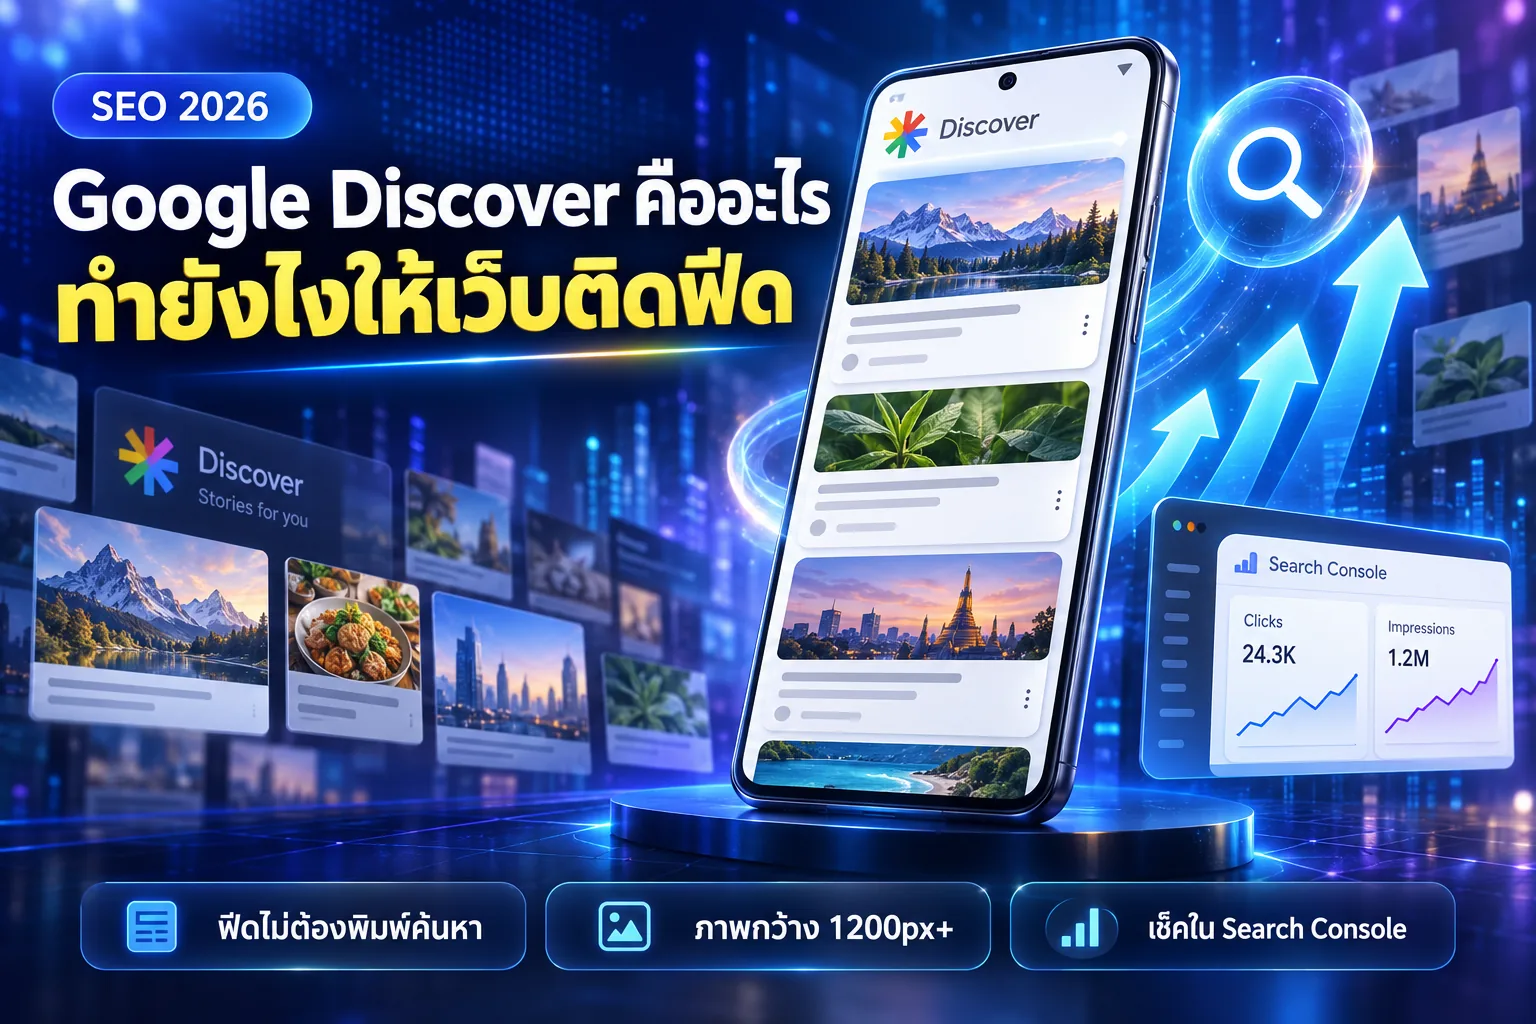
Google Discover คือฟีดแนะนำเนื้อหาที่ Google เลือกมาเสนอให้ผู้ใช้เห็นเอง โดยผู้ใช้ไม่ต้องพิมพ์คำค้นหาอะไรเลย มันแสดงอยู่บนหน้าแรกของแอป Google และหน้าแท็บใหม่ของ Chrome บนมือถือ ในรูปแบบการ์ดบทความเรียงต่อกันพร้อมภาพขนาดใหญ่
หัวใจของระบบนี้คือการเป็น personalized feed หรือฟีดที่ปรับตามผู้ใช้แต่ละคน Google ประกอบภาพความสนใจของผู้ใช้จากข้อมูลอย่าง Web & App Activity ประวัติการค้นหา หัวข้อที่เคยกดอ่าน แอปที่ใช้ และหัวข้อที่ผู้ใช้กดติดตามเอง แล้วจับคู่ความสนใจเหล่านั้นกับเนื้อหาที่มีอยู่บนเว็บ ผลลัพธ์คือคนสองคนที่เปิดแอป Google พร้อมกันจะเห็นการ์ดคนละชุดกันโดยสิ้นเชิง
ในมุมของเจ้าของเว็บ เงื่อนไขการเข้าข่าย (eligibility) ง่ายกว่าที่หลายคนคิด เอกสารทางการของ Google Search Central ระบุว่าเพจจะเข้าเงื่อนไขของ Discover อัตโนมัติถ้าถูก index แล้วและไม่ผิดนโยบายเนื้อหาของ Discover ไม่มี markup พิเศษ ไม่มีการสมัคร ไม่มีการยื่นขอเข้าโปรแกรมใด ๆ แต่ประเด็นสำคัญที่ต้องจำให้แม่นคือ Google เขียนไว้ตรง ๆ ว่าการเข้าเงื่อนไขไม่ได้แปลว่าจะได้แสดงผลจริง เข้าข่ายกับได้ขึ้นฟีดเป็นคนละเรื่องกัน
Google Discover ต่างจาก Google Search ยังไง
ความต่างที่ใหญ่ที่สุดคือ Search เริ่มจากคำค้นที่ผู้ใช้พิมพ์ ส่วน Discover ไม่มีคำค้นเลย ระบบเป็นฝ่ายเสนอเนื้อหาให้เห็นก่อนที่ผู้ใช้จะรู้ตัวว่าอยากอ่านเรื่องนั้นด้วยซ้ำ
ผลที่ตามมาคือวิธีทำงานเปลี่ยนไปทั้งกระบวนการ ใน Search เราวางแผนได้จาก search volume, search intent และช่องว่างของคู่แข่ง แต่ ใน Discover ไม่มีคีย์เวิร์ดให้ยิง ไม่มีอันดับให้ไล่ และไม่มีหน้าผลลัพธ์ให้เทียบกับคู่แข่งแบบตรง ๆ สิ่งที่ทำได้คือทำเนื้อหาให้ตรงกับความสนใจของกลุ่มคนที่เราอยากได้ แล้วให้สัญญาณคุณภาพครบพอที่ระบบจะกล้าหยิบไปเสนอ
อีกจุดที่ต่างชัดคือเสถียรภาพของทราฟฟิก ทราฟฟิกจาก Search ที่มาจากอันดับดี ๆ มักค่อนข้างนิ่งและคาดเดาได้ ส่วนทราฟฟิกจาก Discover ขึ้นลงได้แรงมากในระดับวันต่อวัน เพราะขึ้นกับทั้งกระแสความสนใจของผู้ใช้และการปรับอัลกอริทึมของ Google ตารางด้านล่างสรุปความต่างที่ต้องรู้ก่อนวางแผนคอนเทนต์
| มิติเปรียบเทียบ | Google Search | Google Discover |
|---|---|---|
| จุดเริ่มต้นของทราฟฟิก | ผู้ใช้พิมพ์คำค้นหาเอง | ระบบเสนอเนื้อหาให้เห็นเองในฟีด |
| สิ่งที่ระบบจับคู่ | คำค้น (query) กับเนื้อหาของหน้า | ความสนใจของผู้ใช้รายคนกับเนื้อหา |
| การวางแผนคีย์เวิร์ด | ทำได้ตรง ๆ จาก volume และ intent | ทำแบบเดียวกันไม่ได้ เพราะไม่มี query |
| ความเสถียรของทราฟฟิก | ค่อนข้างนิ่งตามอันดับที่ได้ | ผันผวนสูง ขึ้นลงเร็วเป็นวันต่อวัน |
| น้ำหนักของภาพหน้าปก | มีผลระดับรอง เน้นที่ title กับเนื้อหา | มีผลสูง ภาพเล็กเกินไปได้พื้นที่แสดงผลเล็กลง |
| รายงานใน Search Console | แท็บ Search results มีให้ทุกเว็บ | แท็บ Discover จะโผล่เมื่อมี impression ถึงเกณฑ์ |
อะไรบ้างที่มีผลต่อโอกาสติด Google Discover
สิ่งที่ Google สื่อสารออกมาชัดที่สุดคือคุณภาพเนื้อหาในกรอบ E-E-A-T ความสม่ำเสมอของหัวข้อที่เว็บเขียน และสัญญาณการมีส่วนร่วมของผู้ใช้หลังคลิก ไม่ใช่เทคนิคเชิงโค้ดอะไรเป็นพิเศษ
ก่อนจะลงรายละเอียด ต้องตั้งหลักให้ตรงกันก่อนว่า Google ไม่เคยประกาศรายการปัจจัยจัดอันดับของ Discover แบบชัดเจนตายตัวเหมือนฝั่ง Search สิ่งที่รวบรวมได้คือสิ่งที่เอกสารทางการแนะนำ บวกกับทิศทางของอัปเดตที่ผ่านมา โดยเฉพาะทิศทางของ core update ช่วงหลังที่ให้น้ำหนักกับเนื้อหาคุณภาพมากขึ้นและลดพื้นที่ของคอนเทนต์ล่อคลิก ดังนั้นทุกข้อด้านล่างควรอ่านในฐานะ "แนวทางที่เพิ่มโอกาส" ไม่ใช่สูตรที่ทำแล้วติดแน่นอน
คุณภาพเนื้อหาและสัญญาณ E-E-A-T
Google ย้ำเรื่อง Experience, Expertise, Authoritativeness และ Trustworthiness เป็นกรอบหลักในการประเมินคุณภาพ ซึ่งใช้กับ Discover ด้วย เนื้อหาที่มีประสบการณ์ตรง มีมุมมองที่หาจากที่อื่นไม่ได้ และเขียนโดยคนที่รู้จริงในเรื่องนั้น ได้เปรียบกว่าบทความที่เรียบเรียงจากที่อื่นมาแบบไม่มีอะไรเพิ่ม
จุดที่ทำได้จริงคือใส่ตัวตนคนเขียนให้ชัด ระบุวันที่เผยแพร่และอัปเดต อ้างแหล่งข้อมูลที่ตรวจสอบได้ และเล่าสิ่งที่ลงมือทำจริงแทนการสรุปทฤษฎีอย่างเดียว รายละเอียดเต็มของกรอบนี้อ่านต่อได้ที่ คู่มือ E-E-A-T ฉบับเข้าใจง่าย
ความสม่ำเสมอของหัวข้อ หรือ Topical Authority
เว็บที่เขียนเรื่องกระจัดกระจาย วันนี้การตลาด พรุ่งนี้สูตรอาหาร มะรืนรีวิวมือถือ ทำให้ระบบจับทิศทางความเชี่ยวชาญของเว็บไม่ได้ ซึ่งเป็นปัญหาใหญ่กับฟีดที่ทำงานจากการจับคู่ความสนใจ เพราะระบบต้องตอบให้ได้ว่าเว็บนี้ควรถูกเสนอให้คนที่สนใจเรื่องอะไร
การสร้าง topical authority จึงหมายถึงเลือกแกนหัวข้อที่ชัดแล้วเขียนให้ครบทั้งคลัสเตอร์ ตั้งแต่เรื่องพื้นฐานไปจนถึงเรื่องลึก พร้อมเชื่อมโยงกันด้วย internal link ให้เห็นโครง ไม่ใช่ทิ้งบทความเดี่ยว ๆ ไว้คนละมุมของเว็บ
สัญญาณการมีส่วนร่วมของผู้ใช้
เมื่อการ์ดถูกแสดงในฟีดแล้ว พฤติกรรมของผู้ใช้จะกลายเป็นข้อมูลย้อนกลับ ทั้งอัตราการคลิกจากพาดหัวและภาพ และ dwell time หรือเวลาที่ผู้ใช้อยู่บนหน้าหลังคลิกเข้ามา บทความที่คนกดเข้ามาแล้วเด้งออกทันทีย่อมส่งสัญญาณตรงข้ามกับที่เราต้องการ
นี่คือเหตุผลว่าทำไมพาดหัวเกินจริงถึงเป็นดาบสองคม มันอาจได้คลิกในรอบแรก แต่พอเนื้อหาไม่ตรงกับที่พาดหัวสัญญาไว้ ผู้ใช้ก็ออกเร็ว และหน้านั้นก็เสียโอกาสถูกเสนอซ้ำ ความเร็วในการโหลดหน้าและประสบการณ์บนมือถือจึงสำคัญตามไปด้วย เพราะทราฟฟิกจาก Discover เป็นมือถือเกือบทั้งหมด ดูเกณฑ์ที่ควรผ่านได้ที่ คู่มือ Core Web Vitals
ความทันเหตุการณ์ กับเนื้อหา evergreen
เนื้อหาที่ทันเหตุการณ์มีโอกาสถูกหยิบสูงกว่า เพราะฟีดทำงานกับความสนใจ ณ ช่วงเวลานั้น แต่ข้อเข้าใจผิดที่พบบ่อยคือคิดว่าต้องเป็นเว็บข่าวเท่านั้นถึงจะติด ซึ่งไม่จริง
เนื้อหา evergreen ที่มีคุณภาพก็ถูกเสนอได้เช่นกัน โดยเฉพาะเรื่องที่คนสนใจต่อเนื่องตลอดปี เช่น คู่มือ วิธีทำ หรือการเปรียบเทียบตัวเลือก สิ่งที่ช่วยได้คือการอัปเดตข้อมูลให้สดอยู่เสมอและระบุวันที่อัปเดตให้ชัด แทนที่จะปล่อยบทความเก่าค้างไว้หลายปีโดยไม่แตะเลย
ภาพหน้าปกต้องทำยังไงให้ Discover หยิบไปแสดงเต็มพื้นที่
ข้อกำหนดเรื่องภาพเป็นจุดเทคนิคที่ Google ระบุไว้ชัดที่สุดของ Discover และเป็นจุดที่เว็บไทยจำนวนมากพลาดแบบไม่รู้ตัว เพราะภาพเล็กเกินไปหรือลืมเปิดการตั้งค่าตัวอย่างภาพขนาดใหญ่
ภาพต้องกว้างอย่างน้อย 1,200 พิกเซล มีความละเอียดรวมมากกว่า 300,000 พิกเซล และหน้านั้นต้องเปิด meta robots ค่า max-image-preview:large ถ้าไม่เปิดค่านี้ Google จะแสดงได้แค่ภาพย่อขนาดเล็ก ซึ่งกินพื้นที่ในฟีดน้อยลงมากและทำให้โอกาสถูกคลิกลดลงตามไปด้วย
รายการที่ควรไล่เช็คกับทุกบทความมีดังนี้
- ความกว้างภาพอย่างน้อย 1,200px และความละเอียดรวมเกิน 300,000 พิกเซล เช่น 1280x720 ขึ้นไป
- อัตราส่วนภาพแนะนำที่ 16:9 เพื่อให้พอดีกับการ์ดในฟีดโดยไม่ถูกครอปทิ้งส่วนสำคัญ
- ใส่แท็ก meta name robots content max-image-preview:large ในส่วน head ของหน้า (หลายแพลตฟอร์มตั้งค่านี้ให้อยู่แล้ว แต่ต้องเปิดดูโค้ดจริงยืนยัน)
- ระบุภาพที่ต้องการให้ใช้ผ่าน og:image หรือ schema.org markup เพื่อไม่ให้ Google เดาเอาภาพอื่นในหน้าไปแสดง
- เลี่ยงการใช้โลโก้แบรนด์เป็นภาพหลัก และเลี่ยงภาพที่มีตัวหนังสือ overlay หรือ watermark หนาแน่นจนอ่านยากในขนาดการ์ด
- ตรวจว่าภาพโหลดได้จริงจากภายนอก ไม่ถูกบล็อกด้วย robots.txt หรือระบบป้องกัน hotlink
เช็คยังไงว่าเว็บเราติด Google Discover แล้วหรือยัง
เช็คได้ที่ Google Search Console โดยเข้าเมนู Performance แล้วเลือกแท็บ Discover ซึ่งจะแสดงคลิก อิมเพรสชัน และ CTR เฉลี่ยที่มาจากฟีดโดยเฉพาะ แยกจากผลค้นหาปกติ
จุดที่ทำให้หลายคนสับสนคือแท็บนี้ไม่ได้มีให้ทุกเว็บ รายงาน Discover จะปรากฏก็ต่อเมื่อเว็บมีอิมเพรสชันใน Discover ถึงเกณฑ์ขั้นต่ำในช่วงที่ผ่านมาเท่านั้น ถ้าเปิดเข้าไปแล้วไม่เห็นแท็บนี้เลย แปลว่าเว็บยังไม่เคยติด Discover หรือติดน้อยเกินกว่าจะรายงาน ไม่ได้แปลว่า Search Console ตั้งค่าผิด
เมื่อมีข้อมูลแล้ว สิ่งที่ควรดูไม่ใช่แค่ตัวเลขรวม แต่คือรูปแบบที่ซ่อนอยู่ข้างใน
- ดูรายหน้าว่าบทความประเภทไหนของเราถูกหยิบบ่อย แล้วขยายแนวนั้นต่อ แทนที่จะเดาเอง
- เทียบ CTR ของแต่ละหน้าเพื่อดูว่าพาดหัวและภาพแบบไหนทำงานได้ดีกับกลุ่มผู้อ่านของเรา
- ดูช่วงวันที่ทราฟฟิกพุ่งและตกเพื่อจับความสัมพันธ์กับช่วงเวลาที่เผยแพร่หรือช่วงที่มีกระแส
- แยกข้อมูลตามประเทศเพื่อดูว่าฟีดเสนอเนื้อหาเราให้ผู้อ่านกลุ่มไหนจริง ๆ
- เทียบสัดส่วนทราฟฟิก Discover กับ Search เพื่อประเมินว่าเราพึ่งพาช่องทางที่ผันผวนมากเกินไปหรือยัง
ทำไมเว็บถึงไม่ติด Discover หรืออยู่ ๆ ทราฟฟิกก็หายไป
สาเหตุที่พบบ่อยที่สุดมีสองกลุ่มใหญ่ คือเนื้อหาไม่ผ่านมาตรฐานคุณภาพที่ Google ตั้งไว้ กับปัญหาทางเทคนิคเรื่องภาพและการตั้งค่าตัวอย่างภาพ ส่วนกรณีทราฟฟิกหายกะทันหันทั้งที่ไม่ได้แก้อะไร มักเป็นเรื่องความผันผวนตามธรรมชาติของฟีดมากกว่าการถูกลงโทษ
พาดหัวแบบ clickbait คือความเสี่ยงอันดับหนึ่งของช่องทางนี้ Google ระบุไว้ตรง ๆ ว่าให้เลี่ยงพาดหัวที่ทำให้เข้าใจผิด เกินจริง หรือจงใจกั๊กข้อมูลสำคัญเพื่อล่อให้คลิก และทิศทางของอัปเดตช่วงหลังก็เน้นลดพื้นที่ของคอนเทนต์ประเภทนี้ในฟีดชัดเจนขึ้น เว็บที่เคยได้ทราฟฟิกจากสูตรพาดหัวเร้าอารมณ์จึงเป็นกลุ่มที่เจอผลกระทบหนักที่สุด
สาเหตุที่เจอบ่อยเรียงตามความถี่มีดังนี้
- พาดหัวเกินจริงหรือกั๊กข้อมูล เช่น จั่วหัวว่ามีคำตอบแต่ในเนื้อหาไม่มีจริง
- เนื้อหาเล่นกับความตื่นตระหนกหรือความอยากรู้อยากเห็นเกินพอดี (sensationalism)
- ภาพเล็กเกินเกณฑ์ หรือไม่ได้เปิด max-image-preview:large ทำให้ได้พื้นที่แสดงผลแค่ภาพย่อ
- เนื้อหาบางและตื้น ไม่มีมุมมองใหม่ เขียนแบบเทมเพลตซ้ำ ๆ ทุกบทความ (ดูเพิ่มที่บทความเรื่อง Thin Content)
- หัวข้อของเว็บกระจัดกระจาย ทำให้ระบบจับไม่ได้ว่าควรเสนอเว็บนี้ให้ใคร
- หน้าถูกตั้ง noindex หรือยังไม่ถูก index ซึ่งตัดโอกาสตั้งแต่ต้นทาง
- หน้าโหลดช้าหรือประสบการณ์บนมือถือแย่ ทำให้ผู้ใช้ออกเร็วหลังคลิก
ควรลงแรงกับ Google Discover แค่ไหนถึงจะคุ้ม
คำตอบที่ตรงที่สุดคือ ควรมอง Discover เป็นช่องทางเสริมที่ได้ก็ดี ไม่ได้ก็ต้องอยู่รอด ไม่ใช่ช่องทางหลักที่วางแผนธุรกิจทับลงไป เพราะเป็นช่องทางที่ควบคุมไม่ได้เท่าการทำอันดับจากคำค้น และ Google เองก็แนะนำให้มองแบบนี้
ในทางปฏิบัติ สิ่งที่คุ้มที่สุดคือทำงาน SEO ตามปกติให้ดีอยู่แล้ว แล้วเติมเงื่อนไขฝั่ง Discover เข้าไปโดยไม่ต้องรื้อกระบวนการ นั่นคือเขียนเนื้อหาที่มีมุมมองจริง ตั้งพาดหัวให้ตรงกับสิ่งที่อยู่ในบทความจริง ๆ ทำภาพหน้าปกให้ผ่านเกณฑ์ขนาดทุกชิ้น เปิดค่า max-image-preview ให้ถูก และคุมหัวข้อของเว็บให้อยู่ในแกนเดียวกัน ทั้งหมดนี้เป็นสิ่งที่ช่วยฝั่ง Search ด้วยอยู่แล้ว ไม่ได้เป็นงานที่ทำเพื่อ Discover อย่างเดียว
อีกเรื่องที่ควรวางไว้ในแผนคือการกระจายความเสี่ยง เว็บที่พึ่งทราฟฟิกจากฟีดเป็นสัดส่วนสูงจะเจ็บหนักทุกครั้งที่มีอัปเดต ซึ่งเป็นสถานการณ์เดียวกับที่หลายเว็บเจอจากการเปลี่ยนแปลงฝั่ง AI Search ตามที่เล่าไว้ใน บทความเรื่องผลกระทบของ AI Overview การมีฐานทราฟฟิกจากคำค้นที่มั่นคงไว้ก่อนจึงเป็นเกราะที่ดีที่สุด
ถ้าอยากรู้ว่าเว็บตัวเองติดขัดตรงไหน ทั้งฝั่งเนื้อหา โครงสร้าง และภาพ ทีมงาน SEONo1 รับตรวจและวางแผนคอนเทนต์ให้ได้ตามหน้างานจริง โดยยึดหลักว่าไม่มีใครการันตีการติด Discover ได้ สิ่งที่ทำได้คือทำให้เว็บผ่านเงื่อนไขและมีคุณภาพพอที่ระบบจะเลือกหยิบไปเสนอ
คำถามที่พบบ่อย
01Google Discover ต้องสมัครหรือใส่ code อะไรเพิ่มไหม+
ไม่ต้องสมัครและไม่มี markup พิเศษที่ทำให้ติดได้ Google ระบุว่าเพจจะเข้าเงื่อนไขของ Discover อัตโนมัติถ้าถูก index แล้วและไม่ผิดนโยบายเนื้อหา แต่การเข้าเงื่อนไขไม่ได้แปลว่าจะได้แสดงผลจริง
02เว็บเล็กหรือเว็บธุรกิจทั่วไปที่ไม่ใช่เว็บข่าว มีโอกาสติด Discover ไหม+
มีโอกาส เพราะ Discover ไม่ได้จำกัดเฉพาะข่าวสด เนื้อหา evergreen คุณภาพดีที่ตรงกับความสนใจของผู้ใช้ก็ถูกหยิบไปแสดงได้ แต่ต้องยอมรับว่าเว็บที่มีแกนหัวข้อชัดและมีสัญญาณคุณภาพครบจะได้เปรียบกว่า
03ทำไมใน Search Console ไม่มีแท็บ Discover ให้ดู+
แท็บ Discover จะปรากฏก็ต่อเมื่อเว็บมีอิมเพรสชันใน Discover ถึงเกณฑ์ขั้นต่ำในช่วงที่ผ่านมา ถ้าไม่เห็นแท็บนี้แปลว่าเว็บยังไม่เคยติดหรือติดน้อยเกินกว่าจะรายงาน ไม่ใช่ความผิดพลาดของการตั้งค่า
04ภาพหน้าปกต้องใหญ่แค่ไหนถึงจะได้พื้นที่เต็มในฟีด+
ต้องกว้างอย่างน้อย 1200 พิกเซล มีความละเอียดรวมเกิน 300000 พิกเซล แนะนำอัตราส่วน 16:9 และหน้านั้นต้องเปิดค่า max-image-preview large ในแท็ก meta robots มิฉะนั้น Google จะแสดงได้แค่ภาพย่อขนาดเล็ก
05ทราฟฟิกจาก Discover หายไปกะทันหันทั้งที่ไม่ได้แก้อะไร เกิดจากอะไร+
ส่วนใหญ่เป็นความผันผวนตามธรรมชาติของฟีด เพราะระบบเสนอเนื้อหาตามความสนใจของผู้ใช้ซึ่งเปลี่ยนตลอด บวกกับการปรับอัลกอริทึมเป็นระยะ สิ่งที่ควรทำคือตรวจว่าเนื้อหาและพาดหัวยังตรงตามแนวทางคุณภาพหรือไม่ แล้วกลับไปโฟกัสฐานทราฟฟิกจากคำค้นที่ควบคุมได้มากกว่า